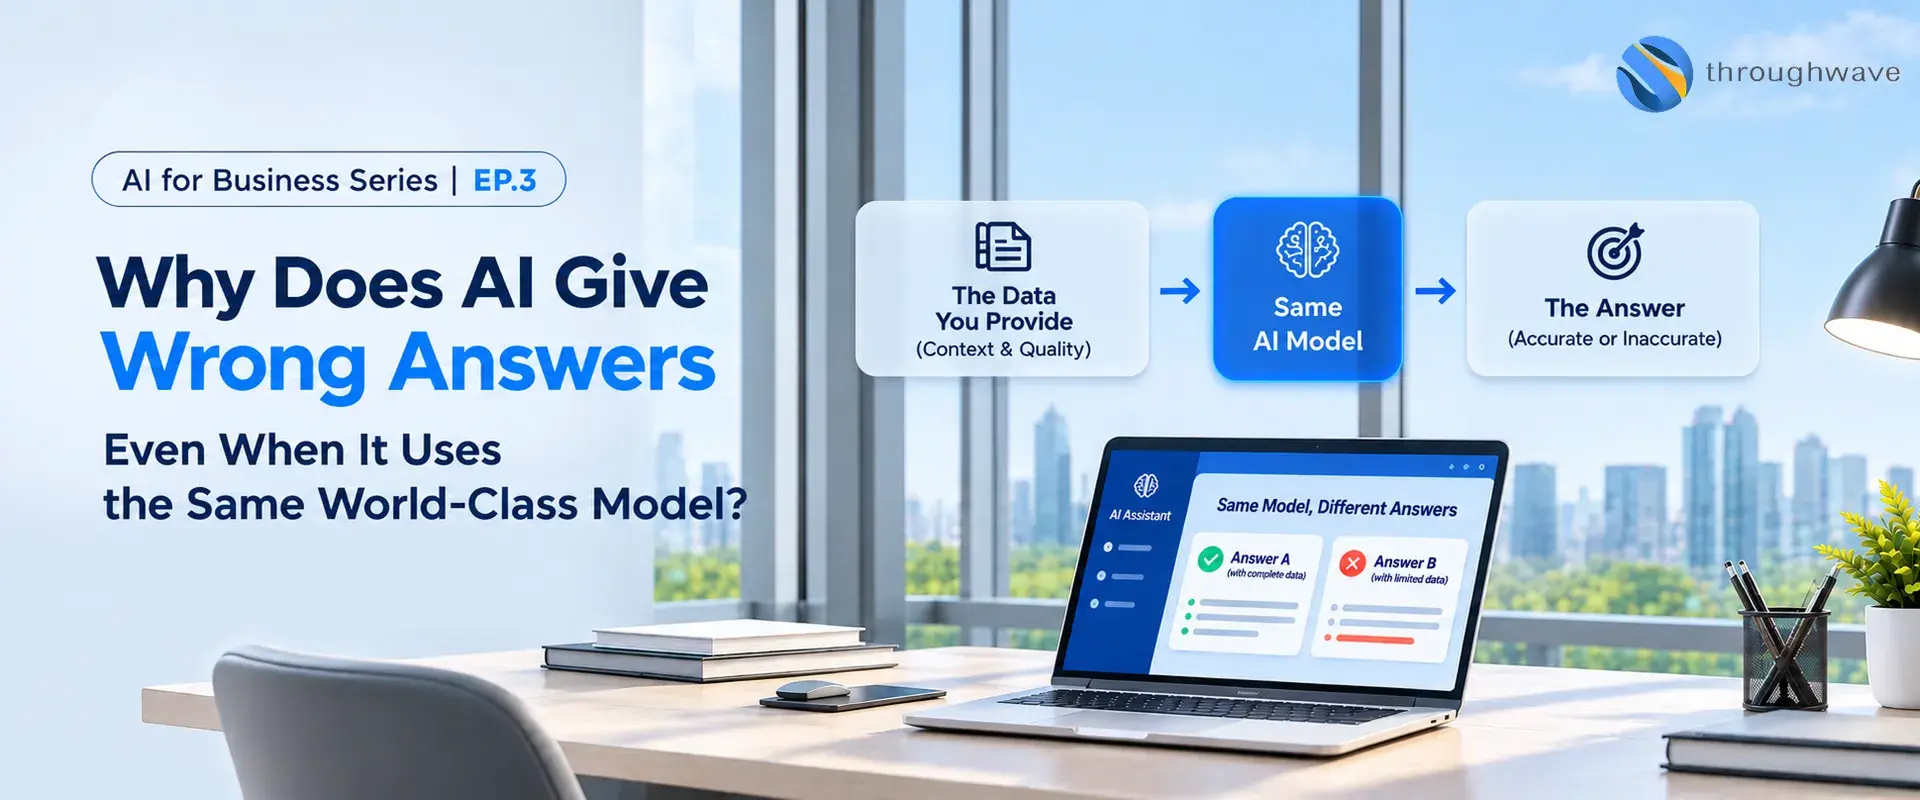
AI for Business Series | EP.3 — ทำไม AI ถึงตอบผิด ทั้งที่ใช้โมเดลระดับโลกตัวเดียวกัน?
เมื่อโมเดลเดียวกัน ไม่ได้การันตีผลลัพธ์ที่เหมือนกัน
ใน EP.1 และ EP.2 เราได้สำรวจความสำคัญของการเชื่อมโยง AI เข้ากับข้อมูลธุรกิจ และการกำจัดจุดติดขัด (Bottleneck) ในระบบนิเวศข้อมูล แต่เมื่อองค์กรเริ่มนำ AI เข้าสู่สถานะใช้งานจริง (Production) สิ่งที่มักสร้างความฉงนใจคือ:
“ทำไมระบบที่ใช้โมเดล AI ตัวเดียวกัน ถึงให้คำตอบที่แม่นยำไม่เท่ากัน?”
คำตอบของ AI ไม่ได้ถูกกำหนดจากเพียง "ชื่อรุ่นโมเดล" แต่เป็นผลผลิตจากสถาปัตยกรรมระบบโดยรวม (System Architecture) ซึ่งประกอบด้วย Context, Prompt, Retrieval, Configuration และคุณภาพของข้อมูลอ้างอิง
ดังนั้น เมื่อ AI ให้คำตอบที่คลาดเคลื่อน คำถามเชิงกลยุทธ์ที่ควรถามไม่ใช่แค่ “เราใช้โมเดลอะไร?” แต่ต้องถามลึกไปถึง “ระบบส่งข้อมูลและบริบทอะไรให้โมเดลก่อนที่จะสร้างคำตอบ?”
Same Model ≠ Same AI System: ความแตกต่างอยู่ที่ "บริบท"
ลองเปรียบเทียบพนักงานสองคนที่ได้รับคำถามเดียวกันว่า “สินค้ารุ่นนี้สามารถเคลม On-site Service ได้หรือไม่?”
- คนที่หนึ่ง: ได้รับคู่มือผลิตภัณฑ์ฉบับล่าสุด พร้อมนโยบายบริการ (Service Policy) ที่ตรงกับประเภทลูกค้า
- คนที่สอง: ได้รับเพียงคู่มือสินค้าฉบับเก่า และไม่มีข้อมูลนโยบายบริการ
แม้ทั้งสองคนจะมีความสามารถในการประมวลผลใกล้เคียงกัน แต่คำตอบที่ได้ย่อมต่างกันอย่างสิ้นเชิง เพราะข้อมูลที่ใช้ประกอบการตัดสินใจไม่เหมือนกัน
AI ก็เช่นเดียวกัน หากระบบค้นคืนข้อมูล (Retrieval) คัดเลือกเอกสารมาไม่ครบถ้วน หรือจัดลำดับความสำคัญของบริบท (Context) ผิดพลาด ข้อมูลที่ถูกส่งไปที่โมเดลก็จะเพี้ยนไปตั้งแต่ต้นน้ำ
หัวใจสำคัญคือ: สิ่งที่คุณใช้งานจริงไม่ใช่แค่ "โมเดล" แต่คือ "ระบบ AI" ทั้งหมดที่ทำงานร่วมกัน
ผ่าโครงสร้างเบื้องหลัง: กว่าจะได้หนึ่งคำตอบต้องผ่านอะไรบ้าง?
ในระบบ Enterprise AI ที่ใช้สถาปัตยกรรม RAG กระบวนการมักจะเป็นดังนี้:
User Question → Query Processing → Retrieval → Context Construction → Prompt Engineering → Model Processing → Final Answer
แต่ละขั้นตอนล้วนเป็นจุดที่อาจเกิดความคลาดเคลื่อนได้:
- Retrieval Failure: หากระบบค้นหาไม่เจอข้อมูลสำคัญ คำตอบจะถูกสร้างบนฐานข้อมูลที่ขาดพร่อง
- Context Overload: หากบริบทที่ส่งให้โมเดลมีข้อมูลที่ไม่เกี่ยวข้อง (Irrelevant) หรือข้อมูลที่ขัดแย้งกันมากเกินไป โมเดลอาจเกิดความสับสนและเลือกข้อมูลผิดจุด
- Prompt Constraints: หากชุดคำสั่ง (Instructions) ไม่รัดกุมพอ เช่น ไม่ได้ระบุให้ใช้เฉพาะข้อมูลองค์กรในการตอบ AI อาจจะนำความรู้ทั่วไปจากอินเทอร์เน็ตมาปนจนเกิดข้อมูลเท็จ
ปรากฏการณ์ "ข้อผิดพลาดแบบลูกโซ่" (Cascading Errors)
สำหรับองค์กรที่ใช้ข้อมูลหลากหลายรูปแบบ เช่น เสียง, ภาพ, หรือวิดีโอ เส้นทางข้อมูลจะยิ่งยาวขึ้น และความผิดพลาดจะขยายตัว (Amplify) ได้ง่ายขึ้น:
- Speech-to-Text พลาด: ถอดเสียงชื่อผลิตภัณฑ์ผิดรุ่น
- Retrieval พลาดตาม: ระบบไปค้นหาคู่มือของผลิตภัณฑ์ผิดรุ่นนั้น
- LLM พลาดสรุป: สร้างคำตอบที่ฟังดูน่าเชื่อถือ แต่เป็นข้อมูลของสินค้าคนละตัว
นี่คือเหตุผลว่าทำไมการใช้ LLM ตัวเดียวกันในสองระบบที่ต่างกัน จึงให้ผลลัพธ์ที่ห่างไกลกันมาก
สถาปัตยกรรมเดียวกัน แต่ถูกสอนมาต่างกัน (Custom Model)
ในกรณีของ Custom Model หรือ Fine-tuned Model คำว่า “โมเดลรุ่นเดียวกัน” ยิ่งต้องใช้อย่างระมัดระวัง เพราะโมเดลที่ใช้โครงสร้างพื้นฐาน (Base Model) เดียวกัน แต่อาจมีพฤติกรรมต่างกันอย่างสิ้นเชิงหากผ่านการฝึกด้วยข้อมูลที่ต่างกันในแง่ของ:
- Data Purity: ความสะอาดของข้อมูลและการติด Label ที่สม่ำเสมอ
- Diversity: ความหลากหลายของข้อมูลที่ครอบคลุมสถานการณ์จริง
- Training–Serving Skew: ความแตกต่างระหว่างสภาพแวดล้อมตอนฝึก (Training) กับสภาพแวดล้อมตอนใช้งานจริง (Serving) เช่น ฝึกด้วยไฟล์เสียงคุณภาพดี แต่ใช้งานจริงผ่านระบบโทรศัพท์ที่มีสัญญาณรบกวน
เมื่อโลกเปลี่ยน แต่ AI ยังอยู่ที่เดิม: ปัญหา Data Drift
แม้ว่าคุณจะไม่ได้ปรับแต่งระบบเลย แต่คุณภาพคำตอบอาจลดลงได้ตามกาลเวลา เนื่องจากข้อมูลในโลกความเป็นจริงมีการเปลี่ยนแปลง (Data Drift) เช่น นโยบายใหม่, สินค้ารุ่นใหม่ หรือพฤติกรรมลูกค้าที่เปลี่ยนไป
หาก Knowledge Base ของ RAG ไม่ได้รับการอัปเดต หรือโมเดลเฉพาะทางไม่ได้รับการ Re-training ด้วยข้อมูลชุดใหม่ ประสิทธิภาพของระบบจะถดถอยลงอย่างหลีกเลี่ยงไม่ได้
กลยุทธ์การวิเคราะห์เมื่อ AI ตอบผิด: อย่าเพิ่งพุ่งเป้าไปที่โมเดล
เมื่อพบว่า AI ให้คำตอบที่คลาดเคลื่อน ควรวิเคราะห์เป็นระดับชั้น (Layered Evaluation) เพื่อหาต้นตอที่แท้จริง:
| จุดที่เกิดปัญหา | อาการที่พบ | แนวทางแก้ไข |
|---|---|---|
| Input / Perception | ถอดเสียงหรืออ่าน OCR ผิดตั้งแต่ต้น | ปรับปรุงโมเดลต้นทาง (Speech/Vision) |
| Retrieval | ค้นไม่เจอเอกสาร หรือเจอข้อมูลที่ไม่เกี่ยวข้อง | ปรับปรุงอัลกอริทึมการค้นหาและการทำ Index |
| Context & Knowledge | อ้างอิงเอกสารเก่า หรือข้อมูลขัดแย้งกัน | ปรับปรุง Data Governance และ Version Control |
| Prompt Engineering | AI ตอบไม่ตรงรูปแบบ หรือนำความรู้ทั่วไปมาปน | ปรับปรุงชุดคำสั่งและการวางโครงสร้าง Prompt |
| Model Capability | ข้อมูล Context ดีแล้ว แต่ AI ยังสรุปผลผิด | พิจารณาอัปเกรดหรือเปลี่ยนรุ่นโมเดลให้เหมาะสม |
การแยกสาเหตุแบบนี้จะช่วยให้องค์กรแก้ปัญหาได้ตรงจุด ประหยัดงบประมาณ และลดการลงทุนที่ซ้ำซ้อนในตัวโมเดลที่อาจไม่ใช่ต้นเหตุของปัญหา
พลิกวิกฤตเป็นโอกาส: การทำ Regression Testing
ทุกคำตอบที่ผิดพลาดคือ "ข้อมูลที่มีมูลค่า" หากเรานำกรณีเหล่านั้นมาวิเคราะห์ ติด Label คำตอบที่ถูกต้องโดยผู้เชี่ยวชาญ และเพิ่มเข้าไปใน Test Set องค์กรจะค่อยๆ สร้างชุดทดสอบที่แข็งแกร่งขึ้นเรื่อยๆ ซึ่งสามารถนำมาใช้ทดสอบซ้ำ (Regression Test) ทุกครั้งที่มีการเปลี่ยนแปลงระบบ เพื่อให้มั่นใจว่าการแก้ปัญหาหนึ่งจะไม่ไปสร้างปัญหาใหม่ในจุดอื่น
7 คำถามสำคัญสำหรับทีม IT และผู้บริหาร เมื่อ AI เข้าสู่สถานะ Production
1. Observability: เมื่อคำตอบคลาดเคลื่อน เราสามารถระบุได้ทันทีหรือไม่ว่าพลาดที่ขั้นตอนใด?
2. Traceability: ระบบสามารถแสดงประวัติข้อมูล (Data Provenance) ว่าดึงเอกสารใดมาใช้ได้หรือไม่?
3. Versioning: เรารู้หรือไม่ว่าคำตอบนี้มาจาก Model รุ่นไหน, Prompt เวอร์ชันใด และ Knowledge Base ชุดไหน?
4. Evaluation Framework: มีชุดทดสอบ (Test Set) ที่แยกขาดจากข้อมูลฝึกเพื่อวัดผลอย่างเป็นกลางหรือไม่?
5. Drift Monitoring: มีการติดตามประสิทธิภาพของระบบเมื่อเผชิญกับข้อมูลใหม่ๆ อย่างต่อเนื่องหรือไม่?
6. Human-in-the-loop: ในงานที่มีความเสี่ยงสูง มีกระบวนการตรวจสอบโดยมนุษย์ที่เหมาะสมหรือไม่?
7. Continuous Improvement: มีกระบวนการนำ Feedback จากการใช้งานจริงกลับมาปรับปรุงข้อมูลและโมเดลอย่างไร?
เป้าหมายของ Enterprise AI ไม่ใช่การรับประกันความถูกต้อง 100% ตลอดเวลา (ซึ่งเป็นไปได้ยาก) แต่คือการมีระบบที่ "ตรวจสอบได้ วิเคราะห์ได้ และปรับปรุงได้อย่างเป็นระบบ" เมื่อเกิดความผิดพลาด
ติดตามต่อใน AI for Business Series | EP.4 Private AI กับ RAG ต่างกันอย่างไร?
หากคุณกำลังเผชิญกับปัญหา AI ตอบไม่สม่ำเสมอ หรือต้องการวางระบบประเมินผล (Evaluation Framework) ที่มีมาตรฐาน Throughwave พร้อมให้คำปรึกษาในการออกแบบสถาปัตยกรรม AI ที่โปร่งใส ตรวจสอบได้ และมีประสิทธิภาพสูงสุดตามโจทย์ธุรกิจของคุณ
บทความที่เกี่ยวข้อง
AI for Business Series | EP.2 — ก่อนทุ่มงบลงทุน AI เพิ่ม... ลองตอบคำถามเชิงยุทธศาสตร์นี้ก่อน: AI ของคุณกำลังประมวลผลจากฐานข้อมูลใด?
28/10/2569
AI for Business Series | EP.1 — AI รอบรู้ข้อมูลทั้งโลก แต่ "รู้จัก" ธุรกิจของคุณดีพอหรือยัง?
20/10/2569

AI Supercomputer แบบติดตั้งภายในองค์กร พร้อมระบบระบายความร้อนด้วย Liquid Cooling
20/6/2569