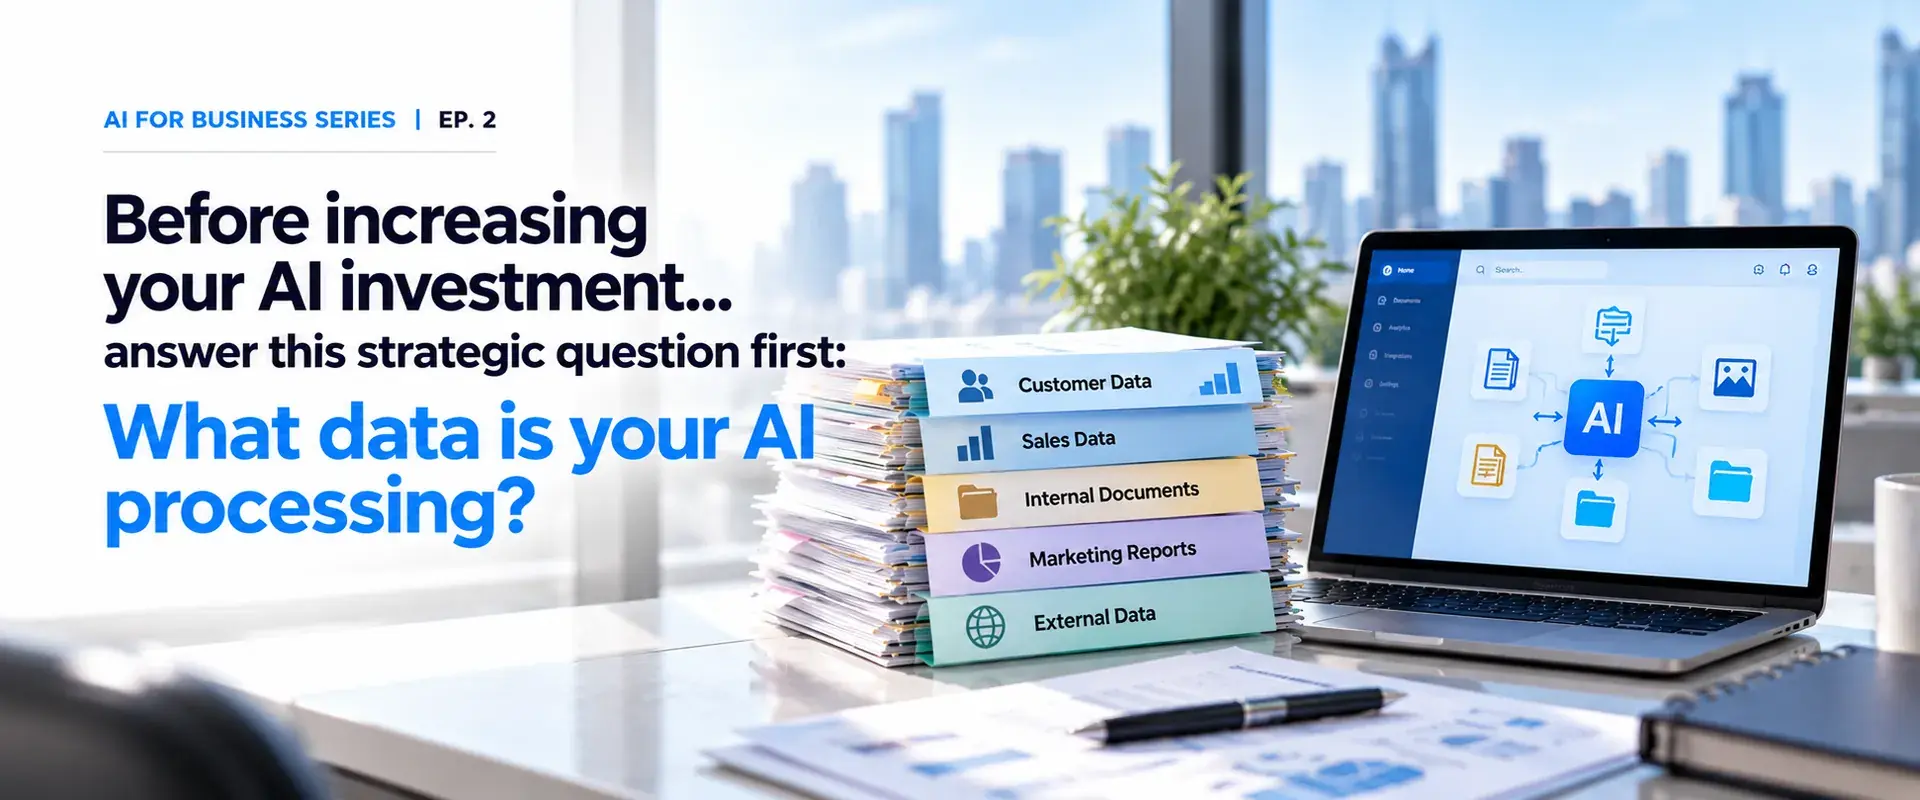
AI for Business Series | EP.2 — ก่อนทุ่มงบลงทุน AI เพิ่ม... ลองตอบคำถามเชิงยุทธศาสตร์นี้ก่อน: AI ของคุณกำลังประมวลผลจากฐานข้อมูลใด?
การเพิ่มประสิทธิภาพ AI: การลงทุนที่ตรงจุดคือหัวใจสำคัญ
หลังจากที่หลายองค์กรเริ่มนำ Generative AI มาปรับใช้ คำถามสำคัญที่ตามมาคือ “หากต้องการผลลัพธ์ที่ดีขึ้น เราควรเพิ่มการลงทุนในส่วนใด?”
- เปลี่ยนไปใช้โมเดลรุ่นใหม่ล่าสุด?
- เพิ่มจำนวนพารามิเตอร์ของโมเดลให้ใหญ่ขึ้น?
- ลงทุนในโครงสร้างพื้นฐาน (Infrastructure) ให้แรงกว่าเดิม?
- หรือเพิ่มงบประมาณให้กับ AI Platform สำเร็จรูป?
คำตอบเหล่านี้อาจถูกในบางบริบท แต่ก่อนที่จะขยายการลงทุน มีหนึ่งปัจจัยพื้นฐานที่ต้องตรวจสอบให้แน่ชัดก่อน:
“ในวันนี้ AI ของคุณกำลังสร้างคำตอบจากข้อมูลชุดใด และข้อมูลเหล่านั้นมีความพร้อมในระดับที่ไว้วางใจได้แล้วหรือยัง?”
ในระบบ Enterprise AI ปัญหาด้านคุณภาพบ่อยครั้งไม่ได้เกิดจากข้อจำกัดของโมเดลเพียงอย่างเดียว แต่เกิดจาก "ระบบนิเวศข้อมูล" (Data Ecosystem) ที่อยู่รายรอบ ไม่ว่าจะเป็นการค้นคืนข้อมูล สิทธิ์การเข้าถึง หรือสถาปัตยกรรมระบบที่ไม่เอื้อต่อการประมวลผล
วิเคราะห์ "เส้นทางข้อมูล" (Data Pipeline) ก่อนเปลี่ยนโมเดล
ลองนึกถึงสถานการณ์ที่พนักงานสอบถามว่า “เงื่อนไขการรับประกันสินค้ารุ่นนี้สำหรับลูกค้าระดับ Enterprise มีรายละเอียดอย่างไร?”
แม้บริษัทจะมีข้อมูลนี้อยู่แล้ว แต่มักจะกระจัดกระจายอยู่ในหลายแหล่ง เช่น คู่มือผลิตภัณฑ์ (Product Manual), นโยบายการขาย (Sales Policy), ประวัติอีเมล หรือระบบแชร์ไฟล์ ปัญหาจึงไม่ใช่แค่ AI เก่งพอจะตอบได้หรือไม่ แต่คือ:
1. Discovery: ระบบทราบหรือไม่ว่าต้องไปค้นหาข้อมูลที่ถูกต้องจากที่ไหน?
2. Authority: ข้อมูลชุดใดคือฉบับล่าสุดที่มีผลบังคับใช้จริง (Source of Truth)?
3. Conflict Resolution: หากข้อมูลจากสองแหล่งขัดแย้งกัน ระบบมีเกณฑ์การตัดสินใจอย่างไร?
ต่อให้คุณเปลี่ยนไปใช้โมเดลที่ฉลาดที่สุด แต่หากระบบค้นคืน (Retrieval) ยังหยิบเอกสารเก่าหรือข้อมูลที่ไม่เกี่ยวข้องมาเป็นบริบท ผลลัพธ์ที่ได้ย่อมคลาดเคลื่อนและสร้างความสับสน
ดังนั้น ก่อนที่จะลงทุนเพิ่มในตัวโมเดล องค์กรควรให้ความสำคัญกับการตรวจสอบ Information Flow ตั้งแต่ต้นน้ำจนถึงปลายน้ำ:
Data Source → Access Permissions → Retrieval Engine → Context Augmentation → AI Processing → Final Answer
หากจุดใดจุดหนึ่งในห่วงโซ่นี้ไม่มีประสิทธิภาพ หรือมีการจัดการสิทธิ์ (Access Control) ที่ไม่รัดกุม คุณภาพและความปลอดภัยของ AI ก็จะลดลงตามไปด้วย
"Big Data" ไม่ได้หมายถึง "AI-Ready Data"
การมีข้อมูลมหาศาลไม่ได้การันตีว่าข้อมูลนั้นพร้อมสำหรับ AI ก่อนที่จะเชื่อมโยงข้อมูลเข้ากับระบบ องค์กรควรมีความชัดเจนใน 5 มิติ ดังนี้:
- Authoritative Source: กำหนดแหล่งข้อมูลหลักที่เป็นทางการ
- Data Ownership: ระบุผู้รับผิดชอบดูแลข้อมูลในแต่ละส่วน
- Lifecycle Management: จัดการเอกสารที่ล้าสมัยหรือถูกแทนที่
- Data Classification: กำหนดระดับความลับของข้อมูลที่ AI สามารถเข้าถึงได้
- Synchronization: มีกระบวนการอัปเดตข้อมูลให้เป็นปัจจุบันอย่างสม่ำเสมอ
หัวใจสำคัญอาจไม่ได้อยู่ที่ตัว AI แต่เป็นเรื่องของ Knowledge Management (KM) และ Data Governance ที่ต้องแข็งแรงพอจะเป็นฐานรากให้ระบบ AI ได้
คุณภาพข้อมูลและฉลากข้อมูล (Data Cleansing & Labeling): จุดตัดระหว่าง "ความเข้าใจ" กับ "การจดจำ"
เมื่อองค์กรขยับไปสู่การทำ Fine-tuning หรือสร้าง Custom Model คุณภาพของข้อมูลจะกลายเป็นตัวแปรที่สำคัญที่สุด เพราะโมเดลไม่ได้เรียนรู้จากความจริงโดยสัญชาตญาณ แต่เรียนรู้จาก ตัวอย่างและฉลากข้อมูล (Label) ที่มนุษย์ป้อนให้
Label ทำหน้าที่เป็น "เฉลย" ของข้อสอบ หากเฉลยผิดพลาด ไม่สม่ำเสมอ หรือขัดแย้งกัน โมเดลจะเรียนรู้ในสิ่งที่ผิดอย่างแม่นยำ ซึ่งนำไปสู่ปัญหาใหญ่ที่เรียกว่า Overfitting
ทำไมคุณภาพของ Label จึงสำคัญต่อการสร้างโมเดลที่ฉลาดจริง
เป้าหมายสูงสุดของการฝึกโมเดลคือการให้ AI เรียนรู้ รูปแบบที่แท้จริง (Pattern Recognition) เพื่อให้สามารถนำไปประยุกต์ใช้กับข้อมูลใหม่ๆ ได้ (Generalization) แต่หากข้อมูลที่ใช้สอนเต็มไปด้วยสัญญาณรบกวน (Noise) โมเดลจะเลือกทางลัดด้วยการ "จดจำ" ตัวอย่างเฉพาะเจาะจงแทนที่จะทำความเข้าใจหลักการ
ผลลัพธ์คือโมเดลที่ทำคะแนนได้ดีเยี่ยมในการทดสอบ (Training Score) แต่ล้มเหลวโดยสิ้นเชิงเมื่อนำไปใช้งานจริงหน้างาน (Production)
สาเหตุหลักของปัญหานี้ ได้แก่:
1. Inconsistency: หากผู้ติด Label นิยามตำหนิแบบเดียวกันต่างกัน (เช่น คนหนึ่งบอกผ่าน อีกคนบอกไม่ผ่าน) โมเดลจะเกิดความสับสน
2. Shortcut Learning: โมเดลเรียนรู้จากปัจจัยที่ไม่เกี่ยวข้อง เช่น จำพื้นหลังหรือสภาพแสงแทนที่จะจำตัวเนื้องานจริง
3. Data Leakage: ข้อมูลในชุดฝึกรั่วไหลไปยังชุดทดสอบ ทำให้ผลการวัดความแม่นยำสูงเกินจริง
4. Skewed Data: ข้อมูลที่ใช้สอนไม่ครอบคลุมสถานการณ์จริงที่หลากหลาย
ในโลกของ Data Science "ชุดข้อมูลขนาดเล็กที่สะอาดและสม่ำเสมอ ให้ผลลัพธ์ดีกว่าชุดข้อมูลขนาดใหญ่ที่เต็มไปด้วย Noise"
แนวทางปฏิบัติในการเตรียมข้อมูล (Data Cleansing & Labeling)
- Data Cleansing: กำจัดข้อมูลซ้ำซ้อน, แก้ไขรูปแบบที่ไม่ตรงกัน, คัดกรองภาพเบลอหรือไฟล์เสียงที่มีปัญหา และทำ Data Masking เพื่อปกปิดข้อมูลส่วนบุคคลตามหลัก PDPA
- Clear Labeling Guidelines: มีนิยามคลาสที่ชัดเจนพร้อมตัวอย่างกรณีที่ก้ำกึ่ง (Edge Cases)
- Inter-annotator Agreement: ใช้ผู้เชี่ยวชาญหลายคนติด Label ในข้อมูลชุดเดียวกันเพื่อวัดความสอดคล้องและหาจุดที่นิยามยังไม่ชัดเจน
- Loop-based Refinement: วิเคราะห์จุดที่โมเดลพลาดเพื่อย้อนกลับไปแก้ไข Label ให้ถูกต้อง (Data-centric AI)
อย่าประเมิน AI เพียงแค่ "คำตอบที่ดูดี"
Generative AI มีความสามารถในการสร้างประโยคที่สละสลวยและน่าเชื่อถือ แต่นั่นอาจเป็นเพียง "เปลือกนอก" สำหรับระดับองค์กร สิ่งที่ต้องวัดผลจริงๆ คือ:
- Groundedness: คำตอบอ้างอิงจากข้อมูลจริงหรือไม่ (ลดโอกาสเกิด Hallucination)?
- Source Reliability: ใช้เอกสารฉบับล่าสุดที่มีผลใช้งานอยู่หรือไม่?
- Authorization Enforcement: ระบบเคารพสิทธิ์การเข้าถึงของผู้ใช้งานแต่ละรายหรือไม่?
- Auditability: เมื่อเกิดความผิดพลาด สามารถตรวจสอบย้อนกลับไปยัง Context ที่ใช้ประมวลผลได้หรือไม่?
การทดสอบ AI ด้วยสถานการณ์จริง (Use Case-based Evaluation) จึงมีความสำคัญกว่าการดูเพียงคะแนน Benchmark สาธารณะ
ค้นหา Bottleneck ให้พบก่อนเพิ่มงบประมาณ
การที่ AI ทำงานได้ไม่ตรงใจ การเปลี่ยนโมเดลอาจเป็นทางเลือกหนึ่ง แต่ไม่ใช่ทางแก้แรกเสมอไป จุดติดขัด (Bottleneck) ของคุณอาจอยู่ที่:
- การจัดการเวอร์ชันเอกสาร (Version Management)
- ประสิทธิภาพของเครื่องมือค้นหา (Retrieval Optimization)
- การกำกับดูแลข้อมูล (Data Governance)
- หรือคุณภาพของข้อมูลที่ใช้สอน (Training Data Quality)
การลงทุนใน AI ที่คุ้มค่า (High ROI) คือการแก้ปัญหาที่ Bottleneck ของระบบ เพื่อให้เทคโนโลยีสามารถทำงานร่วมกับสินทรัพย์ข้อมูลของคุณได้อย่างมีประสิทธิภาพสูงสุด
6 คำถามสำคัญก่อนลงทุน AI รอบถัดไป
- Authoritative Source: แหล่งข้อมูลหลักที่ AI ดึงมาใช้อ้างอิงคืออะไร?
- Version Control: เรามีระบบจัดการข้อมูลที่ล้าสมัยหรือข้อมูลซ้ำซ้อนอย่างไร?
- Retrieval Efficiency: ระบบสามารถค้นหา "บริบทที่ถูกต้อง" ได้ก่อนส่งให้โมเดลประมวลผลหรือไม่?
- Data Quality & Labeling: ข้อมูลที่ใช้สอนสะอาดพอและมีการติดฉลากที่สม่ำเสมอโดยผู้เชี่ยวชาญแล้วหรือยัง?
- Practical Evaluation: เรามีชุดทดสอบจากหน้างานจริง (Ground Truth) เพื่อวัดผลก่อนและหลังการอัปเกรดระบบหรือไม่?
- Root Cause Analysis: ปัญหาที่เรากำลังเจออยู่ที่ตัว Model, Data, หรือ Process กันแน่?
สรุป
หากคุณยังไม่สามารถตอบคำถามเหล่านี้ได้ชัดเจน การลงทุนในโมเดลที่ใหญ่ขึ้นอาจเป็นการแก้ปัญหาที่ปลายเหตุ
ติดตามต่อใน AI for Business Series | EP.3 ทำไม AI ถึงตอบผิด ทั้งที่ใช้โมเดลเดียวกัน? คำตอบอาจไม่ได้อยู่ที่ AI
หากองค์กรของคุณกำลังวางแผนลงทุนด้าน AI และต้องการผู้เชี่ยวชาญในการช่วยประเมินความพร้อม (AI Readiness) หรือต้องการออกแบบโครงสร้างพื้นฐานด้านข้อมูล (Data & AI Architecture) ที่มั่นคง Throughwave พร้อมให้คำปรึกษาและร่วมออกแบบโซลูชันที่เหมาะสมกับ Use Case และข้อกำหนดด้านความปลอดภัยของธุรกิจคุณ เพื่อให้การลงทุนใน AI ของคุณสร้างผลตอบแทนที่วัดผลได้จริง